Copiar texto árabe de um PDF: símbolos e ordem das palavras
O texto árabe vira símbolos ou palavras invertidas ao copiar? Identifique falhas de codificação ou escaneamento e escolha recuperação, exportação ou OCR.

Neste artigo
- Escolha a solução de acordo com o sintoma
- Por que o PDF mostra caracteres estranhos ao copiar
- Como recuperar o texto no GenPDF
- 1. Abra o arquivo
- 2. Confira a aba Texto
- 3. Baixe o arquivo
- Exportar todo o texto de uma vez
- Se a página é uma imagem digitalizada
- Limites da recuperação e diferenças entre leitores
- Como este guia foi escrito
- Perguntas frequentes
Se o árabe aparece corretamente no PDF, mas vira símbolos ao colar, pode faltar informação sobre a codificação das letras. Se a página é uma imagem sem texto selecionável, você precisa de OCR. O editor de PDF em árabe do GenPDF recupera texto de certas fontes antigas. Veja como reconhecer esse caso e exportar o conteúdo.
Você pode esbarrar nisso ao passar uma cláusula de um contrato em árabe para o Word, ao copiar um original para traduzir ou ao reaproveitar o texto de um cardápio. Este guia complementa o das letras árabes separadas ou invertidas ao editar um PDF: lá o problema aparece ao editar, aqui ele aparece ao copiar.
Escolha a solução de acordo com o sintoma
- A aparência está correta, mas o texto colado vira símbolos: tente recuperar a codificação antiga compatível.
- As letras estão corretas, mas as palavras ficam invertidas: exporte para texto ou Word e confira a ordem de leitura.
- Não é possível selecionar palavras: a página pode ser uma imagem ou conter letras convertidas em contornos. Use OCR se não houver texto extraível.
- A proteção impede a cópia: você precisa da senha. Recuperar o texto não remove essa proteção.
Por que o PDF mostra caracteres estranhos ao copiar
Um PDF pode mostrar as letras corretamente mesmo sem associar suas formas aos caracteres de texto adequados. Essa associação é importante para copiar e pesquisar o conteúdo. Para um programa saber a que letra um desenho corresponde, o arquivo precisa de uma tabela que ligue cada desenho a um caractere Unicode. Essa tabela se chama ToUnicode. Quando ela falta ou está incompleta, o leitor devolve o que encontra: símbolos, nomes de glifos ou letras faltando.
O árabe sofre mais que a maioria dos alfabetos porque cada letra tem várias formas, conforme a posição na palavra, e cada forma é um desenho separado. O capítulo 9 do padrão Unicode descreve essas formas. O problema é típico de arquivos gerados por programas mais antigos, como um contrato em árabe impresso em PDF por um sistema de anos atrás.
Montamos um arquivo de teste do jeito que alguns programas de impressão em PDF escreviam o árabe: uma fonte de um byte cujas letras têm nomes como afii62780, sem tabela ToUnicode útil. A página fica certa. Extraímos o texto com quatro programas, antes de abrir o arquivo no GenPDF e depois de baixá-lo do GenPDF:
| Programa | Arquivo original | Arquivo baixado do GenPDF |
|---|---|---|
| Poppler (a ferramenta pdftotext) | caracteres de controle no lugar das letras | texto correto, em ordem |
| PDF.js (a biblioteca de visualização do Firefox) | letras faltando | texto correto, em ordem |
| pypdf | nomes de glifos, como afii62780 | texto correto, em ordem |
| PDFium (o motor do Chrome) | caracteres de controle no lugar das letras | letras corretas, mas com as palavras de uma linha em ordem inversa |
Um exemplo do teste: o PDF.js devolveu a linha “المؤجر شركة النور للعقارات” do arquivo original como “ار رات ا”.
A ordem invertida das palavras no PDFium não apareceu apenas no arquivo reparado: ele também devolveu as palavras das linhas em árabe em ordem inversa no contrato de exemplo saudável que o GenPDF oferece. Se você colar o texto e as palavras vierem de trás para a frente, use a exportação da próxima seção.
Como recuperar o texto no GenPDF
1. Abra o arquivo
Abra o arquivo no GenPDF. Se a fonte dele for do tipo que o GenPDF sabe reparar, aparece esta mensagem e o texto passa a poder ser lido, pesquisado e editado. O reparo acontece no navegador, e o arquivo não é enviado.
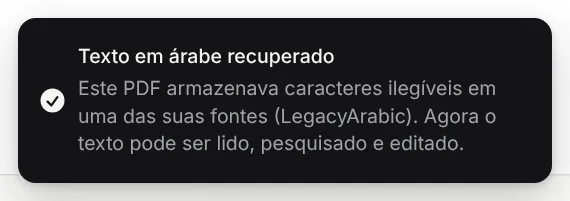
O caso é específico: fontes de um byte cujas letras árabes têm o nome do desenho. Aparece em arquivos impressos em PDF por programas antigos no Windows. O GenPDF não repara todo arquivo danificado, e a mensagem não aparece quando ele não encontra nada a reparar.
2. Confira a aba Texto
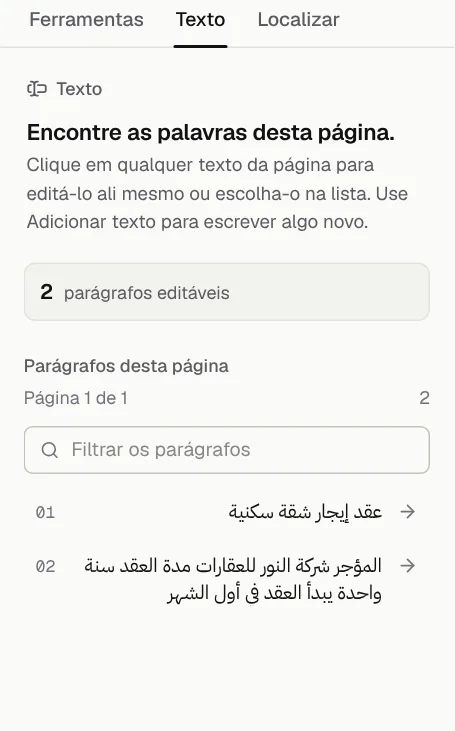
Escolha “Editar texto” e abra a aba “Texto” no painel lateral. Ela lista os “Parágrafos desta página” como texto legível. Se você vê as palavras certas ali, o texto foi recuperado.
3. Baixe o arquivo
Clique em “Baixar”. O arquivo novo leva uma tabela ToUnicode correta, e por isso os outros programas de PDF o leem, como na tabela acima. Confira o texto da cópia baixada e guarde o original para comparar.
Exportar todo o texto de uma vez
Para obter todo o texto sem copiar à mão, abra “Todas as ferramentas”, escolha “PDF para texto” e clique em “Baixar texto”. Você recebe um arquivo .txt com o texto na ordem de leitura. No nosso teste, as quatro linhas saíram certas e na ordem em que a página se lê, mesmo onde o PDFium inverte a ordem das palavras.
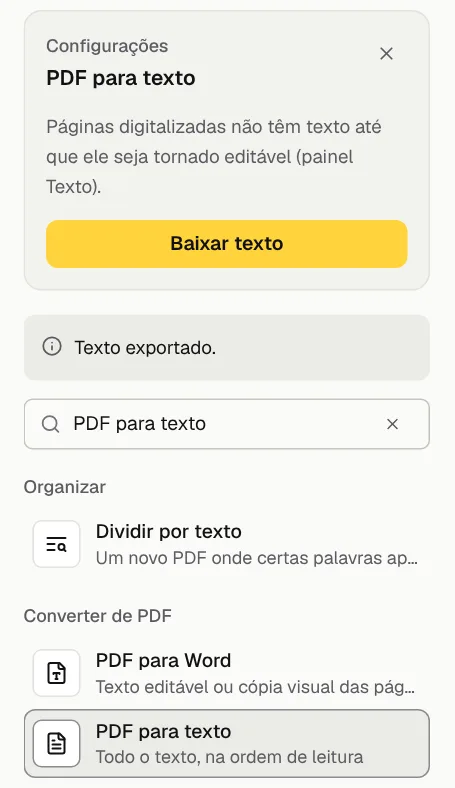
O arquivo separa as páginas com uma linha como “--- Page 2 ---”. A exportação conta como um dos downloads das outras ferramentas: 10 por dia no plano Grátis. Se você prefere um arquivo editável em vez de texto puro, leia como converter PDF em árabe para Word ou use o PDF para Word.
Se a página é uma imagem digitalizada
Uma página digitalizada é uma imagem, então não há texto para copiar. Tente selecionar uma palavra: se a página inteira for selecionada como um bloco, é uma imagem.
Quando você abre um arquivo assim e escolhe “Editar texto”, o GenPDF pergunta antes:
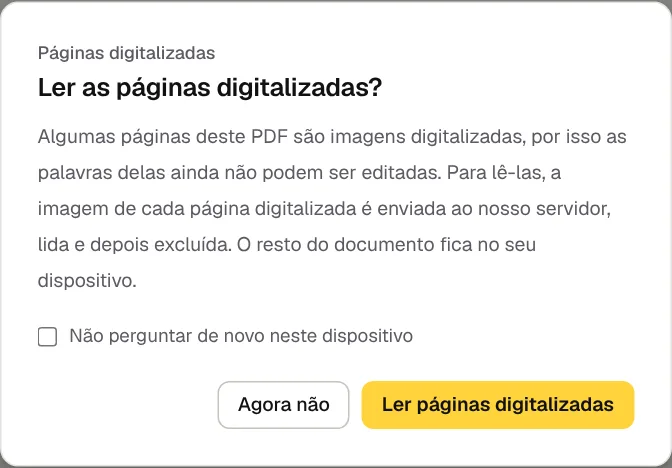
A imagem de cada página digitalizada é enviada ao nosso servidor, lida e excluída, e o resto do documento fica no seu dispositivo. Depois da leitura, as linhas são gravadas no arquivo como texto invisível sobre a imagem, e o arquivo passa a poder ser pesquisado e copiado. O nome técnico é OCR (reconhecimento óptico de caracteres). Para os detalhes, veja o OCR PDF. Para mudar as palavras em si, veja editar PDF digitalizado.
O plano Grátis lê 5 páginas escaneadas por dia e um plano pago lê 100. Todos os planos estão em preços.
Limites da recuperação e diferenças entre leitores
- Outros arquivos danificados. O GenPDF repara só o caso descrito acima. Se a mensagem “Texto em árabe recuperado” não aparece e o texto continua em símbolos, tente o OCR.
- Letras desenhadas como contornos. Alguns arquivos desenham as letras como formas, não como texto. Elas são tratadas como imagem e precisam de OCR.
- Letra manuscrita e digitalização ruim. A leitura não é confiável.
- Texto editado no GenPDF. Ele é gravado como texto de verdade, não como imagem. No nosso teste, porém, o PDF.js juntou sem espaços as palavras do parágrafo editado do arquivo de exemplo, enquanto o Poppler e o PDFium as leram com espaços. Se for copiar um parágrafo editado pelo Firefox, confira os espaços depois de colar.
- Programas que não testamos. Não testamos o Adobe Acrobat Reader. Se o seu caso for diferente, confira o texto colado antes de confiar nele.
- Arquivos protegidos. O GenPDF só desbloqueia um PDF com a senha.
Como este guia foi escrito
Escrito e testado pela equipe do GenPDF em 15 de outubro de 2026, na versão de produção, no Chromium, com arquivos de teste que fizemos para isso, de nomes e conteúdo inventados. Uma IA ajudou a redigir o texto, e uma pessoa testou cada passo. Não executamos a etapa de leitura de página digitalizada no teste, porque o mecanismo de leitura não está instalado no nosso ambiente de teste. O que dizemos sobre ela vem da mensagem do próprio editor e dos testes automáticos do projeto.
Perguntas frequentes
Por que o texto árabe do PDF vira símbolos ou sai de trás para a frente quando eu copio e colo?
Pode faltar informação que associe as formas das letras aos caracteres de texto, como a tabela ToUnicode. Alguns leitores também extraem as palavras em outra ordem. Tente recuperar fontes compatíveis ou exporte para texto ou Word e compare o resultado com a página.
Como saber se o PDF tem texto ou é só uma imagem?
Tente selecionar uma palavra e confira a aba Texto do GenPDF. Se não houver texto selecionável, a página pode ser uma imagem ou conter letras convertidas em contornos. Algumas digitalizações já têm uma camada OCR; a aparência sozinha não basta. A proteção do arquivo também pode impedir a cópia.
Dá para copiar texto de um PDF escaneado?
Dá, depois de lê-lo com OCR. Uma página escaneada é uma imagem sem texto, e o GenPDF a lê depois que você concorda: a imagem de cada página vai ao nosso servidor, é lida e excluída. O plano Grátis lê 5 páginas escaneadas por dia e um plano pago lê 100. Letra manuscrita não é confiável.
Como passar o texto árabe do PDF para o Word?
Em Opções de download, escolha Salvar como Word para obter um arquivo .docx, ou use PDF para texto para baixar um .txt com todo o texto na ordem de leitura. Se o arquivo for escaneado, leia as páginas primeiro. O plano Grátis inclui 2 exportações para Word por dia, de até 20 páginas cada.
O PDF não deixa copiar e a opção está cinza. O que fazer?
O GenPDF só desbloqueia um PDF quando você informa a senha. Sem a senha, ele não remove a proteção. Se você tem a senha, desbloqueie o arquivo primeiro e depois copie o texto.
O arquivo vai para algum servidor quando eu leio uma página digitalizada?
Só a imagem da página digitalizada, e só depois que você concorda. Recuperar e exportar o texto acontece no navegador, sem envio. A imagem enviada é lida e depois excluída do servidor.


