Copiar texto árabe de un PDF: símbolos y orden de palabras
¿El texto árabe se pega como símbolos o palabras invertidas? Identifica problemas de codificación o escaneo y elige recuperación, exportación u OCR.

En este artículo
- Elige la solución según el síntoma
- Por qué el árabe sale como símbolos
- Cómo recuperar el texto en GenPDF
- 1. Abre el archivo
- 2. Comprueba la pestaña Texto
- 3. Descarga el archivo
- Exportar todo el texto de una vez
- Si la página es una imagen escaneada
- Límites de recuperación y diferencias entre lectores
- Cómo se escribió esta guía
- Preguntas frecuentes
Si el árabe se ve bien en el PDF pero se pega como símbolos, puede faltar información sobre la codificación de sus letras. Si la página es una imagen sin texto seleccionable, necesita OCR. El editor de PDF en árabe de GenPDF puede recuperar texto de ciertas fuentes antiguas. Aquí explicamos ese caso y las opciones de exportación.
Les pasa a menudo a quienes traducen del árabe o lo estudian: copias un párrafo de un poder notarial, de una sentencia o de unos apuntes del curso y, al pegarlo en Word, solo salen cuadros y signos. Aquí están las causas y lo que puedes hacer.
Elige la solución según el síntoma
- Se ve bien, pero se pega como símbolos: prueba la recuperación de la codificación antigua compatible.
- Las letras son correctas, pero las palabras están invertidas: exporta a texto o Word y comprueba el orden de lectura.
- No puedes seleccionar palabras: puede ser una imagen o texto convertido en contornos. Usa OCR si no hay texto extraíble.
- La protección impide copiar: necesitas la contraseña. Recuperar texto no elimina esa protección.
Por qué el árabe sale como símbolos
Un PDF puede mostrar las letras correctamente y, aun así, no relacionar sus formas con los caracteres de texto adecuados. Esa relación es necesaria para copiar y buscar el contenido. Para que un programa sepa qué letra representa un dibujo, el archivo necesita una tabla que asocie cada dibujo con un carácter Unicode. Esa tabla se llama ToUnicode. Cuando falta o está incompleta, el lector devuelve lo que encuentra: símbolos, nombres de glifos o letras que faltan.
El árabe lo sufre más que otras escrituras porque una letra tiene varias formas según su posición en la palabra, y cada forma es un dibujo distinto. El capítulo 9 del estándar Unicode describe esas formas.
Construimos un archivo de prueba como lo escribían algunos programas de impresión a PDF: una fuente de un solo byte cuyas letras se llaman, por ejemplo, afii62780, sin una tabla ToUnicode útil. La página se ve bien. Extrajimos su texto con cuatro programas, antes de abrirlo en GenPDF y después de descargarlo desde GenPDF. Probado el 15 de octubre de 2026:
| Programa | Archivo original | Archivo descargado desde GenPDF |
|---|---|---|
| Poppler (la herramienta pdftotext) | caracteres de control en lugar de letras | texto correcto y en orden |
| PDF.js (la biblioteca del visor de Firefox) | letras que faltan | texto correcto y en orden |
| pypdf | nombres de glifos como afii62780 | texto correcto y en orden |
| PDFium (el motor de Chrome) | caracteres de control en lugar de letras | letras correctas, pero con las palabras de cada línea en orden inverso |
Un ejemplo de la prueba: de la línea «المؤجر شركة النور للعقارات» del original, PDF.js devolvió «ار رات ا».
El orden inverso de PDFium no apareció únicamente en el archivo reparado: PDFium también devolvió en orden inverso las palabras de las líneas árabes del contrato de ejemplo de GenPDF, que está sano. Si pegas texto y ves las palabras al revés, usa la exportación de la sección «Exportar todo el texto de una vez».
Cómo recuperar el texto en GenPDF
1. Abre el archivo
Abre el archivo en GenPDF. Si su fuente es de las que GenPDF sabe reparar, aparece este mensaje y el texto pasa a poder leerse, buscarse y editarse. La reparación se hace en tu navegador y el archivo no se sube.
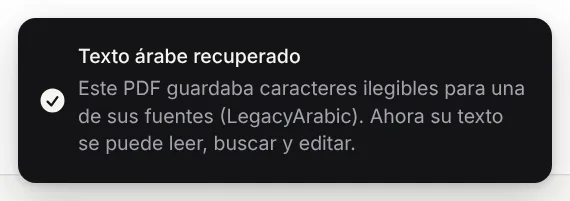
El caso es concreto: fuentes de un solo byte cuyas letras árabes se llaman como sus dibujos. Aparece en archivos impresos a PDF por programas antiguos en Windows. GenPDF no repara todos los archivos dañados, y el mensaje no aparece si no encuentra nada que reparar.
2. Comprueba la pestaña Texto
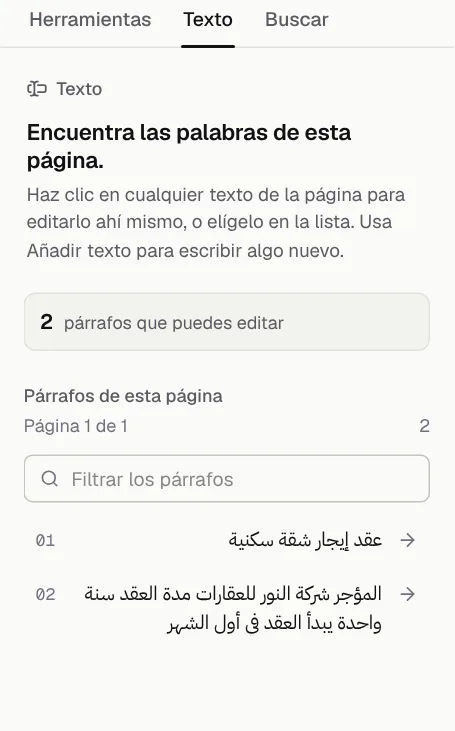
Elige «Editar texto» y abre la pestaña «Texto» del panel lateral. Lista los «Párrafos de esta página» como texto legible. Si ves bien las palabras aquí, el texto se ha recuperado.
3. Descarga el archivo
Haz clic en «Descargar». El archivo nuevo lleva una tabla ToUnicode correcta, así que otros programas de PDF lo leen bien, como en la tabla de arriba. Comprueba el texto de la copia descargada y conserva el original para comparar.
Exportar todo el texto de una vez
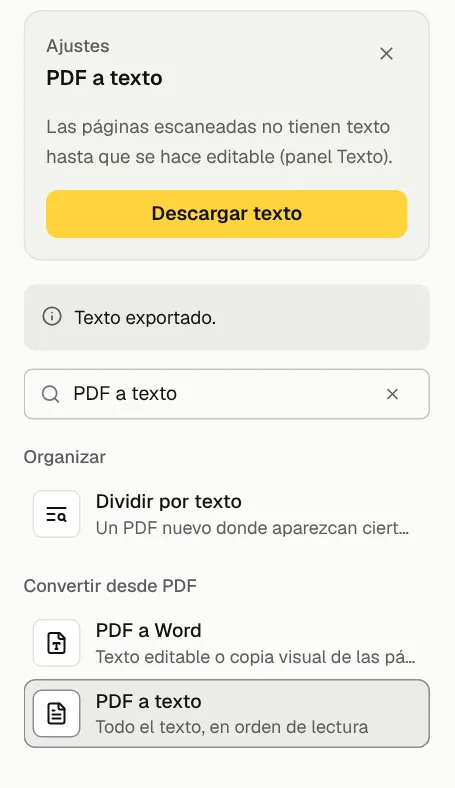
Para tener todo el texto sin copiar a mano, abre «Todas las herramientas», elige «PDF a texto» y haz clic en «Descargar texto». Obtienes un archivo .txt con el texto en orden de lectura; el mensaje final es «Texto exportado». En nuestra prueba, las cuatro líneas salieron bien y en el orden de lectura de la página, incluso donde PDFium invierte el orden de las palabras.
El archivo separa las páginas con una línea como «--- Page 2 ---» (el rótulo va en inglés). La exportación cuenta como una de las descargas de las demás herramientas: 10 al día en el plan gratis. Si quieres un archivo editable en lugar de texto sin formato, lee cómo convertir un PDF en árabe a Word o usa PDF a Word.
Si la página es una imagen escaneada
Una página escaneada es una imagen, así que no hay texto que copiar. Intenta seleccionar una palabra: si se selecciona toda la página como un bloque, es una imagen.
Cuando abres un archivo así y eliges «Editar texto», GenPDF te pregunta antes:
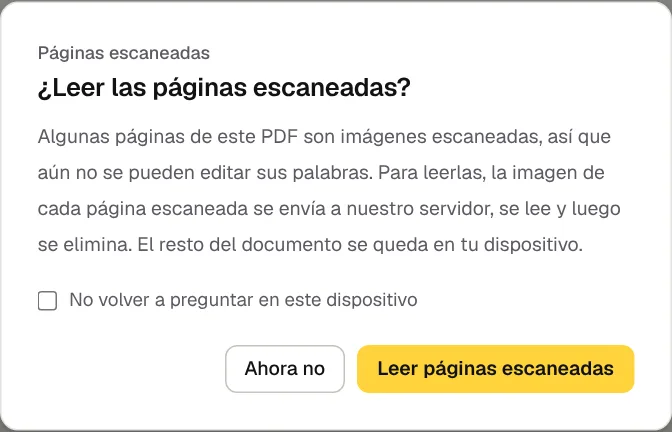
La imagen de cada página escaneada se envía a nuestro servidor, se lee y se elimina, y el resto del documento se queda en tu dispositivo. Después de leerla, las líneas se escriben en el archivo como texto invisible sobre la imagen, de modo que el archivo se puede buscar y copiar. Hay más detalles en OCR para PDF. Para cambiar las palabras de un escaneo, mira editar un PDF escaneado.
El plan gratis lee 5 páginas escaneadas al día y un plan de pago, 100. Todos los planes están en la página de precios.
Límites de recuperación y diferencias entre lectores
- Otros archivos dañados. GenPDF solo repara el caso descrito arriba. Si no aparece el mensaje «Texto árabe recuperado» y el texto sigue siendo símbolos, prueba con OCR.
- Letras dibujadas como contornos. Algunos archivos dibujan las letras como formas, no como texto. Se tratan como imágenes y necesitan OCR.
- Letra manuscrita y escaneos malos. Leerlos no es fiable.
- Texto que editaste en GenPDF. Se escribe como texto real, no como imagen. Aun así, en nuestra prueba PDF.js juntó sin espacios las palabras del párrafo editado del archivo de ejemplo, mientras que Poppler y PDFium las leyeron con espacios. Si vas a copiar un párrafo editado desde Firefox, revisa los espacios al pegar.
- Programas que no probamos. No probamos Adobe Acrobat Reader. Si tu caso es distinto, revisa el texto pegado antes de fiarte.
Si tu problema es que las letras se separan o se invierten al editar el archivo, y no al copiarlo, lee por qué se separan las letras árabes al editar un PDF.
Cómo se escribió esta guía
Escrito y probado por el equipo de GenPDF el 15 de octubre de 2026. Las pruebas de extracción de texto se hicieron ese día en una versión de producción de GenPDF, en Chromium, con archivos de prueba hechos para la ocasión, con nombres y contenidos inventados; para esta versión no las repetimos. Las capturas están hechas en la interfaz en español. No ejecutamos el paso de leer páginas escaneadas porque el motor de lectura no está instalado en nuestro entorno de pruebas, así que lo que decimos de él viene del mensaje del propio editor y de las pruebas automáticas del proyecto. Una herramienta de IA ayudó a redactar el texto y una persona probó los pasos.
Preguntas frecuentes
¿Por qué al copiar un PDF me salen símbolos?
Puede faltar información que relacione las formas de las letras con sus caracteres de texto, como la tabla ToUnicode. Además, algunos lectores extraen las palabras en otro orden. Prueba la recuperación de fuentes compatibles o exporta a texto o Word y compara el resultado con la página.
¿Cómo copio texto de un PDF escaneado?
Hay que leerlo antes con OCR. Una página escaneada es una imagen sin texto, así que GenPDF la lee cuando tú lo aceptas: la imagen de cada página se envía a nuestro servidor, se lee y se elimina. El plan gratis lee 5 páginas escaneadas al día y un plan de pago, 100. La letra manuscrita no es fiable.
¿Cómo sé si mi PDF tiene texto o es solo una imagen?
Intenta seleccionar una palabra y revisa la pestaña Texto de GenPDF. Si no hay texto seleccionable, la página puede ser una imagen o contener letras convertidas en contornos. Algunos escaneos ya tienen una capa OCR; el aspecto por sí solo no basta. La protección del archivo también puede impedir copiar.
¿Cómo paso el texto árabe de un PDF a Word para traducirlo?
Elige Guardar como Word en el menú de la flecha junto a Descargar para obtener un archivo .docx, o usa la herramienta PDF a texto para descargar un archivo .txt con todo el texto en orden de lectura. Si el archivo está escaneado, lee antes sus páginas. El plan gratis incluye 2 exportaciones a Word al día, de hasta 20 páginas.
¿Por qué se pegan las palabras árabes al revés si el PDF está bien?
Porque algunos lectores de PDF devuelven las palabras de una línea árabe en orden inverso aunque el archivo esté sano. En nuestra prueba pasó con PDFium, el motor de Chrome, incluso con el contrato de ejemplo de GenPDF. La exportación a texto de GenPDF las entrega en orden de lectura.
¿Hay que subir mi archivo para recuperar el texto?
No en el caso habitual. Recuperar y exportar el texto ocurre en tu navegador. La única excepción es leer una página escaneada, que solo ocurre si tú lo aceptas.


