Arabischen PDF-Text kopieren: Zeichen und Wortfolge prüfen
Beim Kopieren aus PDF wird Arabisch zu Sonderzeichen oder umgekehrten Wörtern? Finden Sie die Ursache und wählen Sie Textexport, Textrettung oder OCR.

In diesem Artikel
- Die passende Lösung nach Fehlerbild wählen
- Warum Arabisch als Sonderzeichen erscheint
- Text in GenPDF wiederherstellen
- 1. Datei öffnen
- 2. Reiter „Text“ prüfen
- 3. Datei herunterladen
- Den ganzen Text auf einmal exportieren
- Wenn die Seite ein Scan ist
- Grenzen der Wiederherstellung und Unterschiede bei PDF-Lesern
- Wie dieser Artikel entstanden ist
- Häufige Fragen
Sieht Arabisch im PDF richtig aus, wird beim Einfügen aber zu Sonderzeichen, kann die Zeichenzuordnung fehlen. Bei einer Bildseite ohne auswählbaren Text brauchen Sie dagegen OCR für PDF. Der Editor für arabische PDFs kann Text aus bestimmten älteren Schriften wiederherstellen. Diese Anleitung erklärt den Unterschied und die Möglichkeiten zum Textexport.
Das kennt, wer ein arabisches PDF von einer Hochschule, einer Hausverwaltung oder einer Botschaft bekommt und den Text für eine Übersetzung oder ein Formular braucht: Man markiert, kopiert, fügt ein, und es erscheinen komische Zeichen. Zerfallen oder drehen sich die Buchstaben dagegen erst beim Bearbeiten, lesen Sie Arabische Buchstaben im PDF getrennt: Ursache und Lösung.
Die passende Lösung nach Fehlerbild wählen
- Richtige Darstellung, Sonderzeichen beim Einfügen: versuchen Sie die Wiederherstellung der unterstützten älteren Zeichencodierung.
- Richtige Buchstaben, umgekehrte Wortfolge: exportieren Sie als Text oder Word und prüfen Sie die Lesereihenfolge.
- Keine Wörter auswählbar: die Seite kann ein Bild oder in Konturen umgewandelte Schrift enthalten. Ohne auslesbaren Text benötigen Sie OCR.
- Kopieren durch Dateischutz gesperrt: Sie benötigen das Passwort. Die Textwiederherstellung hebt den Schutz nicht auf.
Warum Arabisch als Sonderzeichen erscheint
Ein PDF kann Buchstaben korrekt anzeigen, obwohl ihre Zuordnung zu Textzeichen fehlt oder unvollständig ist. Diese Zuordnung ist für das Kopieren und Suchen wichtig. Damit ein Programm weiß, für welchen Buchstaben eine Zeichnung steht, braucht die Datei eine Tabelle, die jede Zeichnung einem Unicode-Zeichen zuordnet. Sie heißt ToUnicode. Fehlt sie oder ist sie unvollständig, gibt das Programm zurück, was es findet: nur Sonderzeichen, Glyphennamen oder fehlende Buchstaben.
Arabisch trifft das stärker als die meisten Schriften, weil ein Buchstabe je nach Stellung im Wort mehrere Formen hat und jede Form eine eigene Zeichnung ist. Die Formen beschreibt das Unicode-Standardwerk, Kapitel 9.
Wir haben eine Testdatei gebaut, so wie manche Druckprogramme früher arabischen Text geschrieben haben: eine Ein-Byte-Schrift, deren Buchstaben wie afii62780 heißen, ohne brauchbare ToUnicode-Tabelle, mit vier erfundenen arabischen Zeilen. Die Seite sieht richtig aus. Am 15. Oktober 2026 haben wir ihren Text mit drei Programmen ausgelesen, einmal aus der Originaldatei und einmal aus der Datei, die wir aus GenPDF heruntergeladen haben:
| Programm | Originaldatei | Aus GenPDF heruntergeladene Datei |
|---|---|---|
| Poppler (das Werkzeug pdftotext) | Steuerzeichen statt der meisten Buchstaben, dazwischen vereinzelte Buchstaben | richtiger Text, in der richtigen Reihenfolge |
| pypdf | Glyphennamen wie afii62780 | richtiger Text, in der richtigen Reihenfolge |
| PDFium (die Engine von Chrome) | Steuerzeichen statt Buchstaben | richtige Buchstaben, aber die Wörter einer Zeile in umgekehrter Reihenfolge |
Die umgekehrte Wortfolge bei PDFium trat nicht nur bei der reparierten Datei auf. PDFium gab auch beim gesunden Beispielmietvertrag von GenPDF die Wörter der arabischen Zeilen in umgekehrter Reihenfolge aus. Stehen die Wörter beim Einfügen verdreht da, nutzen Sie den Export im übernächsten Abschnitt.
Text in GenPDF wiederherstellen
1. Datei öffnen
Öffnen Sie die Datei in GenPDF. Gehört ihre Schrift zu der Art, die GenPDF reparieren kann, erscheint diese Meldung, und der Text wird lesbar, durchsuchbar und bearbeitbar. Die Reparatur läuft in Ihrem Browser, die Datei wird nicht hochgeladen.
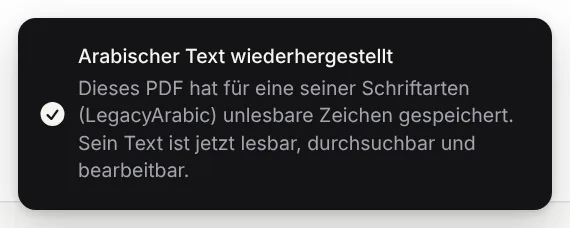
Der Fall ist eng umrissen: Ein-Byte-Schriften, deren arabische Buchstaben nach ihrer Zeichnung benannt sind. Er tritt bei Dateien auf, die ältere Windows-Programme als PDF gedruckt haben. GenPDF repariert nicht jede beschädigte Datei, und die Meldung erscheint nicht, wenn es nichts zu reparieren findet.
2. Reiter „Text“ prüfen
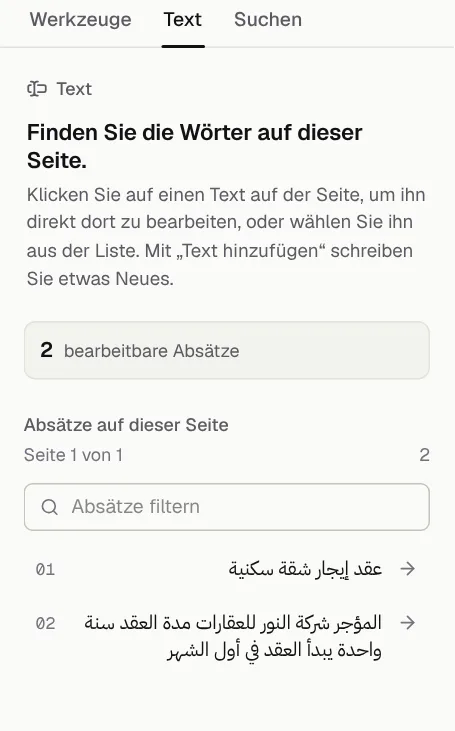
Wählen Sie „Text bearbeiten“ und öffnen Sie in der Seitenleiste den Reiter „Text“. Er listet die „Absätze auf dieser Seite“ als lesbaren Text. Sehen Sie die Wörter hier richtig, ist der Text wiederhergestellt.
3. Datei herunterladen
Klicken Sie auf „Herunterladen“. Die neue Datei enthält eine korrekte ToUnicode-Tabelle, andere PDF-Programme lesen sie also, wie die Tabelle oben zeigt. Nehmen Sie die heruntergeladene Kopie mit und verlassen Sie sich nicht auf das Original.
Den ganzen Text auf einmal exportieren
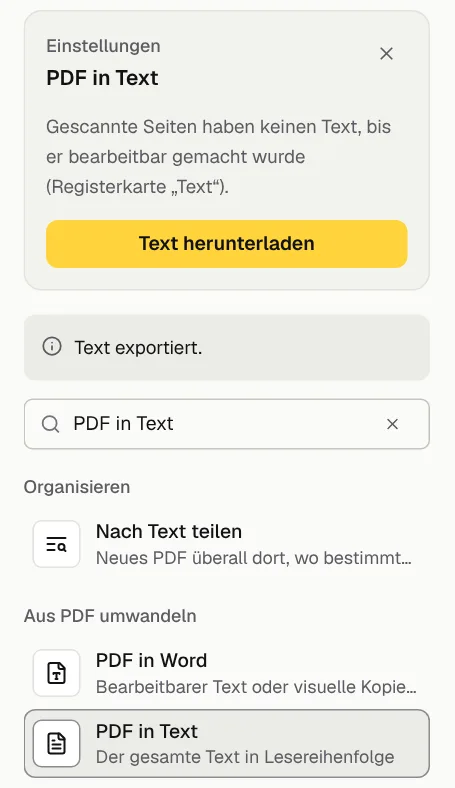
Um den Text ohne Kopieren von Hand zu bekommen, öffnen Sie „Alle Werkzeuge“, wählen „PDF in Text“ und klicken auf „Text herunterladen“. Sie erhalten eine .txt-Datei mit dem Text in Lesereihenfolge. In unserem Test kamen alle vier Zeilen richtig und in der Reihenfolge der Seite heraus, auch dort, wo PDFium die Wortfolge umdreht. Solche Textdateien lassen sich zum Beispiel an ein Übersetzungsbüro weitergeben.
Mehrseitige Dateien trennt das Werkzeug mit einer Zeile wie „--- Page 2 ---“. Der Export zählt als einer der Downloads aus den anderen Werkzeugen, im kostenlosen Tarif 10 pro Tag. Wollen Sie statt Rohtext eine bearbeitbare Datei, lesen Sie Arabisches PDF in Word umwandeln oder nutzen Sie PDF in Word.
Wenn die Seite ein Scan ist
Eine gescannte Seite ist ein Bild, deshalb gibt es keinen Text zum Kopieren. Probieren Sie, ein Wort zu markieren: Wird die ganze Seite als ein Block markiert, ist sie ein Bild.
Öffnen Sie eine solche Datei und wählen „Text bearbeiten“, fragt GenPDF zuerst:
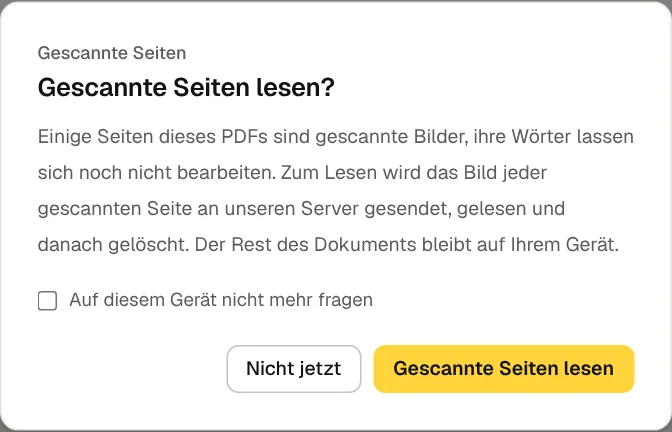
Zum Lesen wird das Bild jeder gescannten Seite an unseren Server gesendet, gelesen und danach gelöscht. Der Rest des Dokuments bleibt auf Ihrem Gerät. Nach dem Lesen steht der Text unsichtbar über den gescannten Wörtern im PDF, sodass sich die Datei durchsuchen und kopieren lässt. Einzelheiten stehen auf der Seite OCR für PDF. Wollen Sie die Wörter des Scans ändern, lesen Sie gescanntes PDF bearbeiten.
Der kostenlose Tarif liest 5 gescannte Seiten pro Tag, ein bezahlter Tarif 100. Alle Tarife stehen auf der Seite Preise. Das Lesen selbst haben wir in diesem Test nicht ausgeführt. Was hier dazu steht, stammt aus der Oberfläche und der Beschreibung des Werkzeugs.
Grenzen der Wiederherstellung und Unterschiede bei PDF-Lesern
- Andere beschädigte Dateien. GenPDF repariert nur den oben beschriebenen Fall. Erscheint „Arabischer Text wiederhergestellt“ nicht und besteht der Text weiterhin aus Sonderzeichen, versuchen Sie OCR.
- Buchstaben als Umrisse. Manche Dateien zeichnen Buchstaben als Formen, nicht als Text. Sie gelten als Bilder und brauchen OCR.
- Handschrift und schlechte Scans. Das Lesen ist hier nicht verlässlich.
- Programme, die wir nicht getestet haben. Wir haben Adobe Acrobat Reader nicht ausprobiert, ebenso wenig Firefox. Weicht Ihr Fall ab, prüfen Sie den eingefügten Text, bevor Sie sich darauf verlassen.
- Keine Beglaubigung, keine Übersetzung. GenPDF stellt Text her und ändert Dateien. Es bestätigt nicht, dass ein Dokument echt ist, und es ersetzt keine beglaubigte Übersetzung.
Wie dieser Artikel entstanden ist
Wir haben die Tests am 15. Oktober 2026 an der Produktionsversion von GenPDF in Chromium durchgeführt, mit deutscher Oberfläche und mit Testdateien, die wir dafür gebaut haben und deren Inhalt erfunden ist. Eine KI hat beim Entwurf des Textes geholfen. Eine Person hat die Schritte im Programm nachvollzogen und den Text gelesen.
Geschrieben und getestet vom GenPDF-Team am 15. Oktober 2026.
Häufige Fragen
Warum werden arabische Buchstaben beim Kopieren aus dem PDF zu komischen Zeichen?
Die Zuordnung zwischen sichtbaren Buchstabenformen und Textzeichen kann fehlen oder unvollständig sein, etwa in der ToUnicode-Tabelle. Außerdem können PDF-Leser Wörter in einer anderen Reihenfolge ausgeben. Versuchen Sie die Wiederherstellung unterstützter Schriften oder den Export als Text oder Word und vergleichen Sie das Ergebnis.
Wie kopiere ich Text aus einem gescannten PDF?
Erst nachdem er gelesen wurde (OCR). Eine gescannte Seite ist ein Bild ohne Text. GenPDF liest sie nach Ihrer Zustimmung: Das Bild jeder Seite wird an unseren Server gesendet, gelesen und gelöscht. Der kostenlose Tarif liest 5 gescannte Seiten pro Tag, ein bezahlter Tarif 100. Handschrift ist nicht verlässlich.
Woran erkenne ich, ob ein PDF Text oder nur ein Bild enthält?
Versuchen Sie, ein einzelnes Wort zu markieren, und prüfen Sie den Reiter Text in GenPDF. Ohne auswählbaren Text kann die Seite ein Bild oder Schriftkonturen enthalten. Manche Scans besitzen bereits eine OCR-Textebene; das Aussehen allein reicht deshalb nicht aus. Auch Dateischutz kann das Kopieren sperren.
Kann ich den kopierten arabischen Text an eine Übersetzerin oder einen Übersetzer weitergeben?
Ja. Über das Werkzeug „PDF in Text“ laden Sie eine .txt-Datei mit dem ganzen Text in Lesereihenfolge herunter, die sich weitergeben oder in jedes andere Programm einfügen lässt. Lesen Sie den Text vorher kurz gegen die Seite. Eine gescannte Datei muss zuerst gelesen werden, und Handschrift liest GenPDF nicht verlässlich.
Wie bekomme ich arabischen Text aus einem PDF nach Word?
Wählen Sie unter „Download-Optionen“ den Eintrag „Als Word speichern“, dann erhalten Sie eine .docx-Datei. Der kostenlose Tarif enthält 2 Word-Exporte pro Tag mit je bis zu 20 Seiten. Eine gescannte Datei muss vorher gelesen werden.
Wird meine Datei hochgeladen, wenn ich den Text auslese?
Im Normalfall nicht. Das Wiederherstellen und das Exportieren des Textes geschehen in Ihrem Browser. Die einzige Ausnahme ist das Lesen einer gescannten Seite, und das geschieht erst nach Ihrer Zustimmung.


